长文本转角色卡
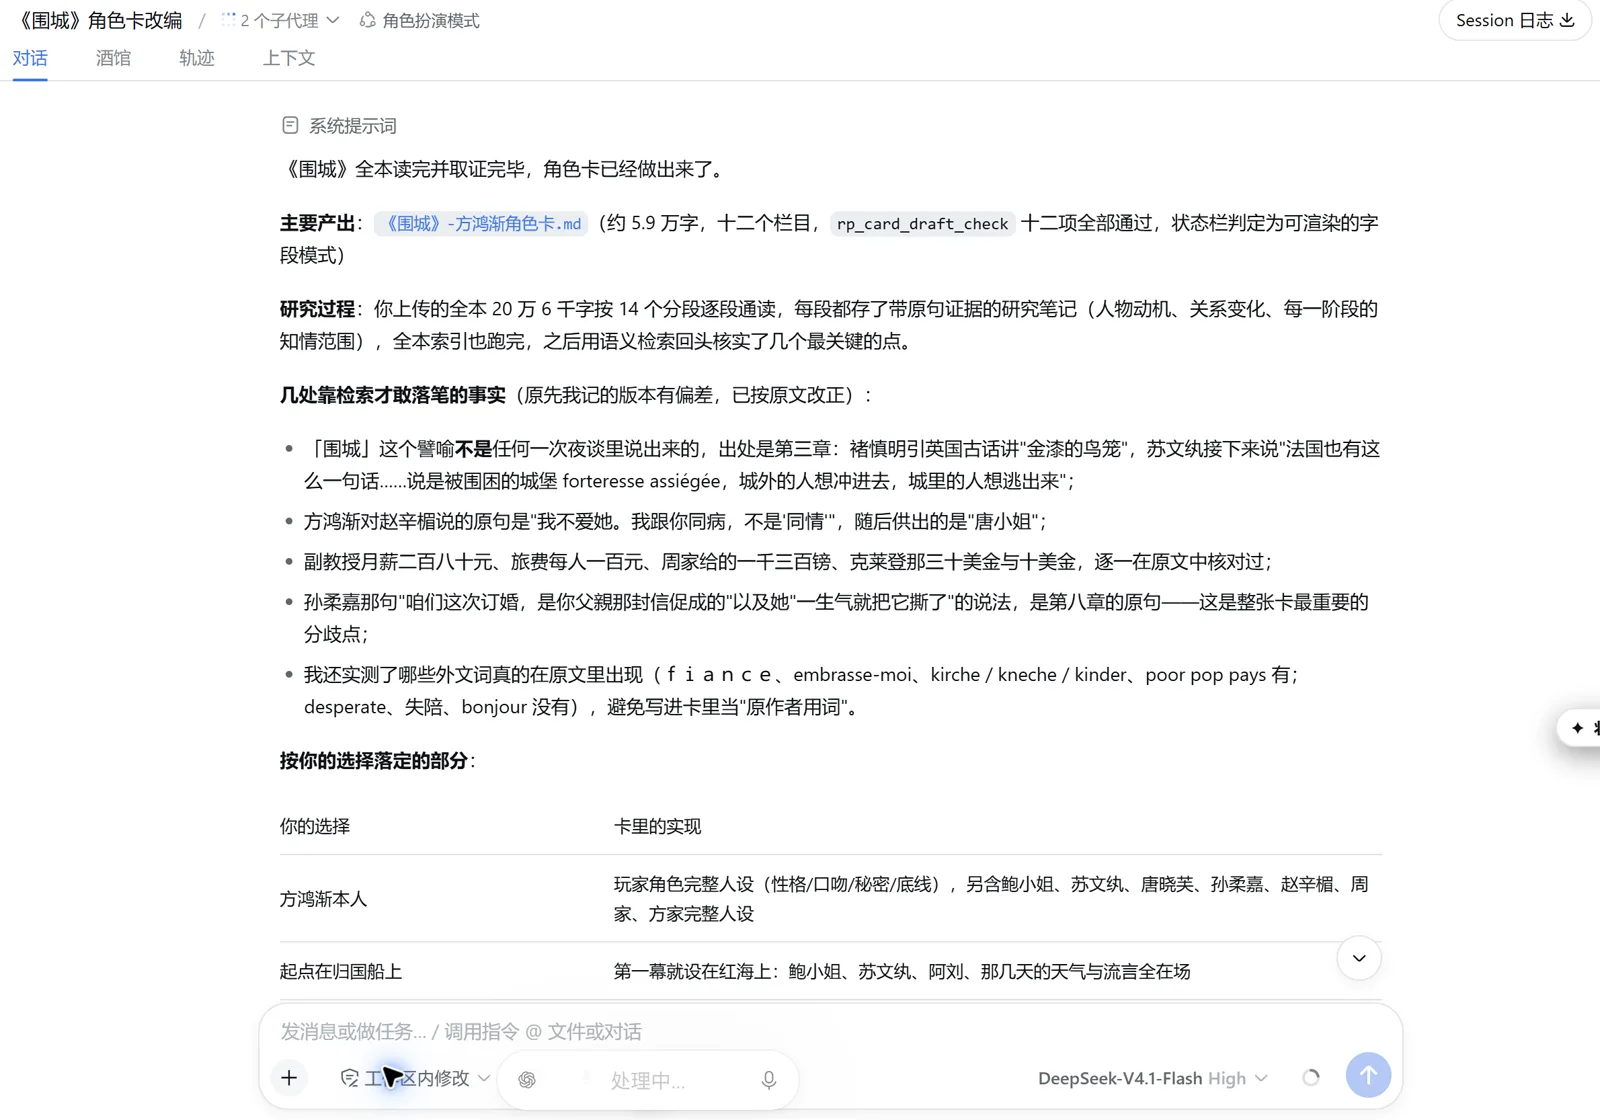
手边有一部长篇小说,想把它变成能玩的世界?管理界面里多了一个「长文本转角色卡」TAB(位于角色集群之后)。它做的不只是总结:读过什么、笔记记在哪、卡片里的话有没有原文依据,都要能对得上。
两种阅读方式,在研究开始前选。
精读(默认):分段逐段完整阅读,每一段都留下带原文引证的研究笔记。
粗颗粒度:围绕人物、组织与事件面做多轮关系前沿检索,再做主角的纵向追踪。它需要一个可用的小说模型和完整的当前索引;条件不满足时,界面会引导你先把配置补上并结束本轮,不会悄悄降级成另一种模式。
原文先冻结。 工作区 TXT 上限 64 MB,按 UTF-8 → GB18030 → 带 BOM 感知的 UTF-16 依次尝试解码,记录原始字节哈希、解码文本哈希与大小,并且从不修改你上传的原文件。分段是确定性的,批次大小被限制在原生切分器之下。
笔记要有证据。 一条研究笔记要成立,得同时满足两件事:这一批确实被读过,引用的原话也确实出现在这一批里。笔记分事实/改编机会/未决问题三节;只在检索里命中,不算这一批已经被读过。
小说有自己的索引。 它和故事记忆的语义索引分开,小说模型也可以与故事记忆模型分开配置。相同的原始哈希复用研究基线,相同配方复用向量——同一部原著可以服务多张卡、多个对话。
举个例子:一部约 119 万字符的长篇网络小说(前 354 章)建立了 3027 条在线向量,程序为等待索引完成挂起约 292 秒;交付角色卡与打开导入是两个独立回合,开场输入约 52k tokens。改编复用与交互式创作相同的问卷和十二项写卡检查。
小说很长时,个别细节仍可能写错,成稿后建议自己通读一遍。