记忆系统
故事越写越长,人物的经历、埋下的伏笔和未完成的约定也在积累。NextTavern 借鉴 Codex 类长任务的上下文管理思路,把长篇记忆拆成四件各有边界的事:固定设定不压缩始终注入 + 有尾部保留的上下文硬切窗口 + 可追溯来源的后台导演笔记 + 关键词和语义混合历史上下文查询召回。
| 支柱 | 它做什么 | 写长篇时有什么用 |
|---|---|---|
| 固定设定不压缩,始终注入 | 冻结的设定与系统前缀每轮都在场,从不进入压缩流程。 | 身份、作者规则和叙事约束是长期契约,不该被一段摘要替换掉。 |
| 硬切窗口 + 尾部保留 | 程序按完整正文边界推进上下文窗口,并在推进时保留尾部连续正文。 | 近期正文保持完整细节,你正在读的那一段不会因为切窗口而丢失,也不会在场景中途被摘要掉。 |
| 可追溯来源的后台导演笔记 | 由独立的后台任务撰写,每条笔记带来源哈希与同一世界线锚点。 | 每条笔记都能追回到写出它的那段正文;追不回来的旧记录会留在原处,程序不会替它猜。追加式原始历史从不删除。 |
| 关键词和语义混合的历史召回 | 主代理按需查询历史,三种方式:关键词(默认)/语义/混合。 | 需要旧细节时再回查原文,而不是每轮都先强制召回一次。 |
flowchart TD
    Player[玩家输入与角色卡] --> Program[程序装配:固定设定 + 硬切窗口 + 有效笔记]
    Program --> Writer[主代理与原生 Agent Loop]
    Writer <--> Recall[按需历史查询:关键词 / 语义 / 混合]
    Writer <--> Lore[按需读取世界书]
    Writer --> Story[流式正文与追加式剧情记录]
    Story --> Background[后台任务:整理导演笔记]
    Background --> Anchor[来源哈希与世界线锚点校验]
Anchor --> Program三种查询方式,同一份语料
查询的语料是玩家输入与有效剧情正文,包含已经归档或被淘汰的正文;状态、工具输出、CSS、决策卡和推理过程都不会进去。
| 方式 | 谁来算 | 什么时候用 |
|---|---|---|
| 关键词(默认) | 程序确定性匹配,不调用模型。 | 想找明确的词句、人名、地名时最快。 |
| 语义 | 需要嵌入模型把查询编码成向量。 | 只记得大意、不记得原话时更有效。 |
| 混合 | 关键词与向量结果一起排序。 | 兼顾精确命中与语义相近。 |
向量是派生的共享数据,查询时会过滤到当前世界线,所以切换世界线不用重建索引。每份向量索引都带一个配方指纹(模型、修订、维度、任务角色、池化方式、量化与运行时):指纹对不上时,索引会被标记为 stale 并停止对外服务,直到你重建为止——它宁可让你重建,也不会拿旧向量凑出错误答案。分块大小全局可配置,默认 480 字符(192/480/960 三个选项,128–2048 区间,80 重叠),本地模型使用 512 的分词预算。清空、重建与填充都限定在当前可见对话及其全部世界线;清空只清索引,正文、来源和账本都留着。
旧笔记与旧状态不再随每次请求发送
旧导演笔记与旧状态快照以前会跟着每次请求一起走(约 52k 字符)。现在它们只在有效的新锚点准备好之后才被替换:没被替换的引用保持原本的精确内容,回滚时重新提供完整文本,原始事件始终是追加式的。写长故事时,请求里不会一直拖着越来越重的旧笔记。
同样的“先确认再替换”也用在很长的工具结果上:一条研究笔记被确认后,对应的长工具结果会被替换成匹配的检查点,前提是归属、来源哈希、generation 与 packetIds 全部一致。部分保存、来源不符、写入失败,以及确认之后又重读过的情况,都不会回收。
这些都可以按会话调整
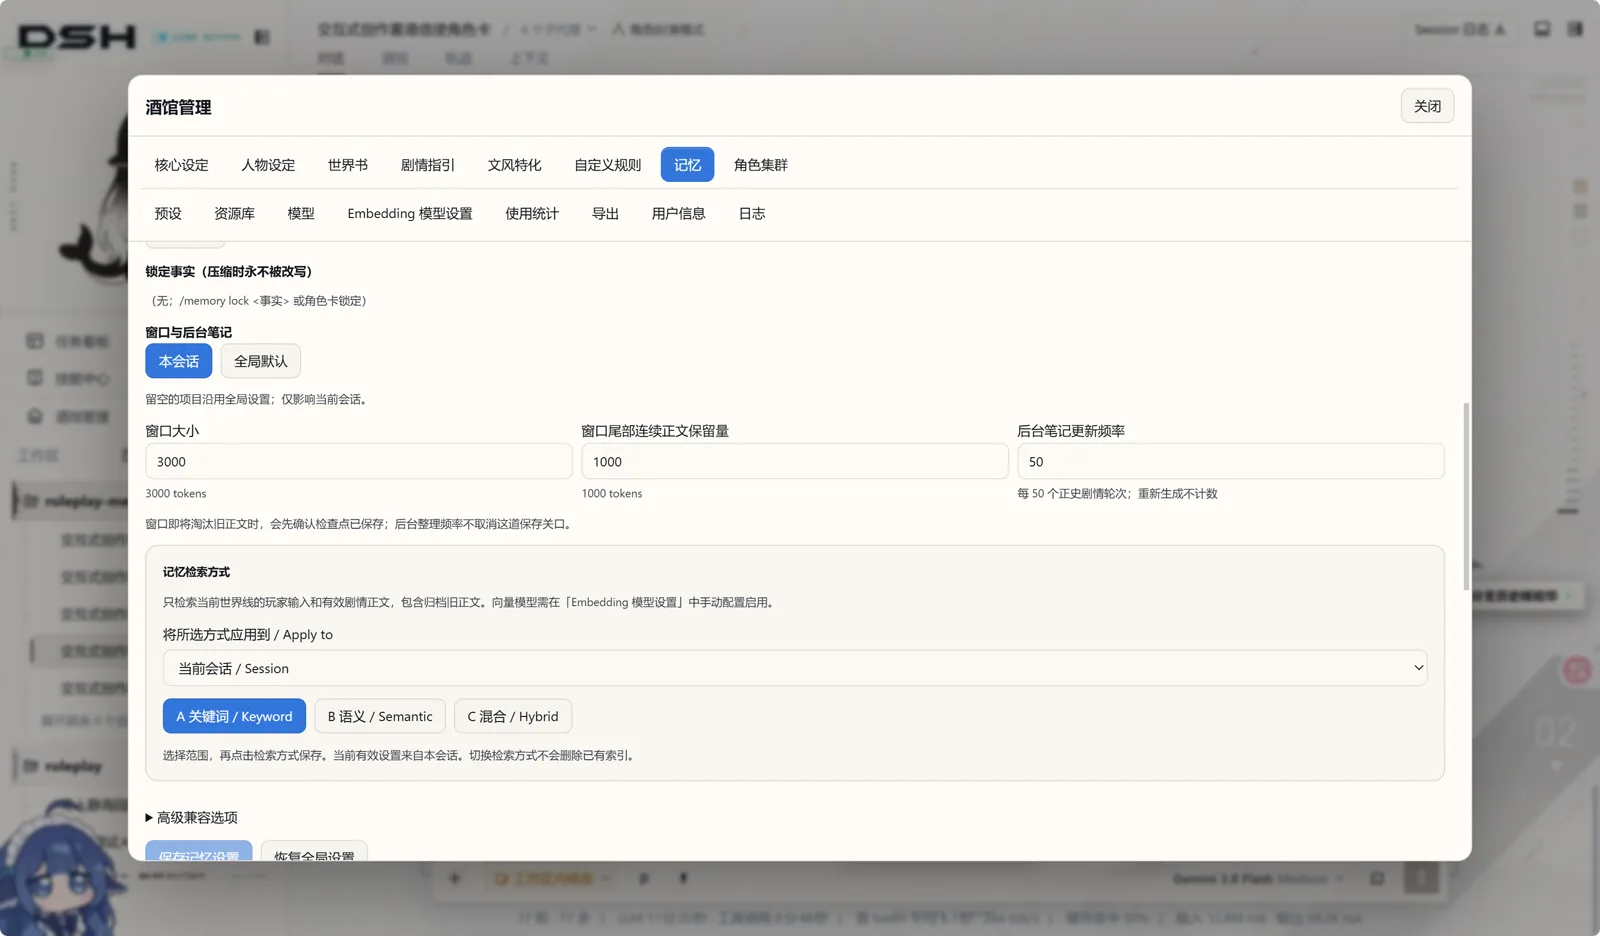
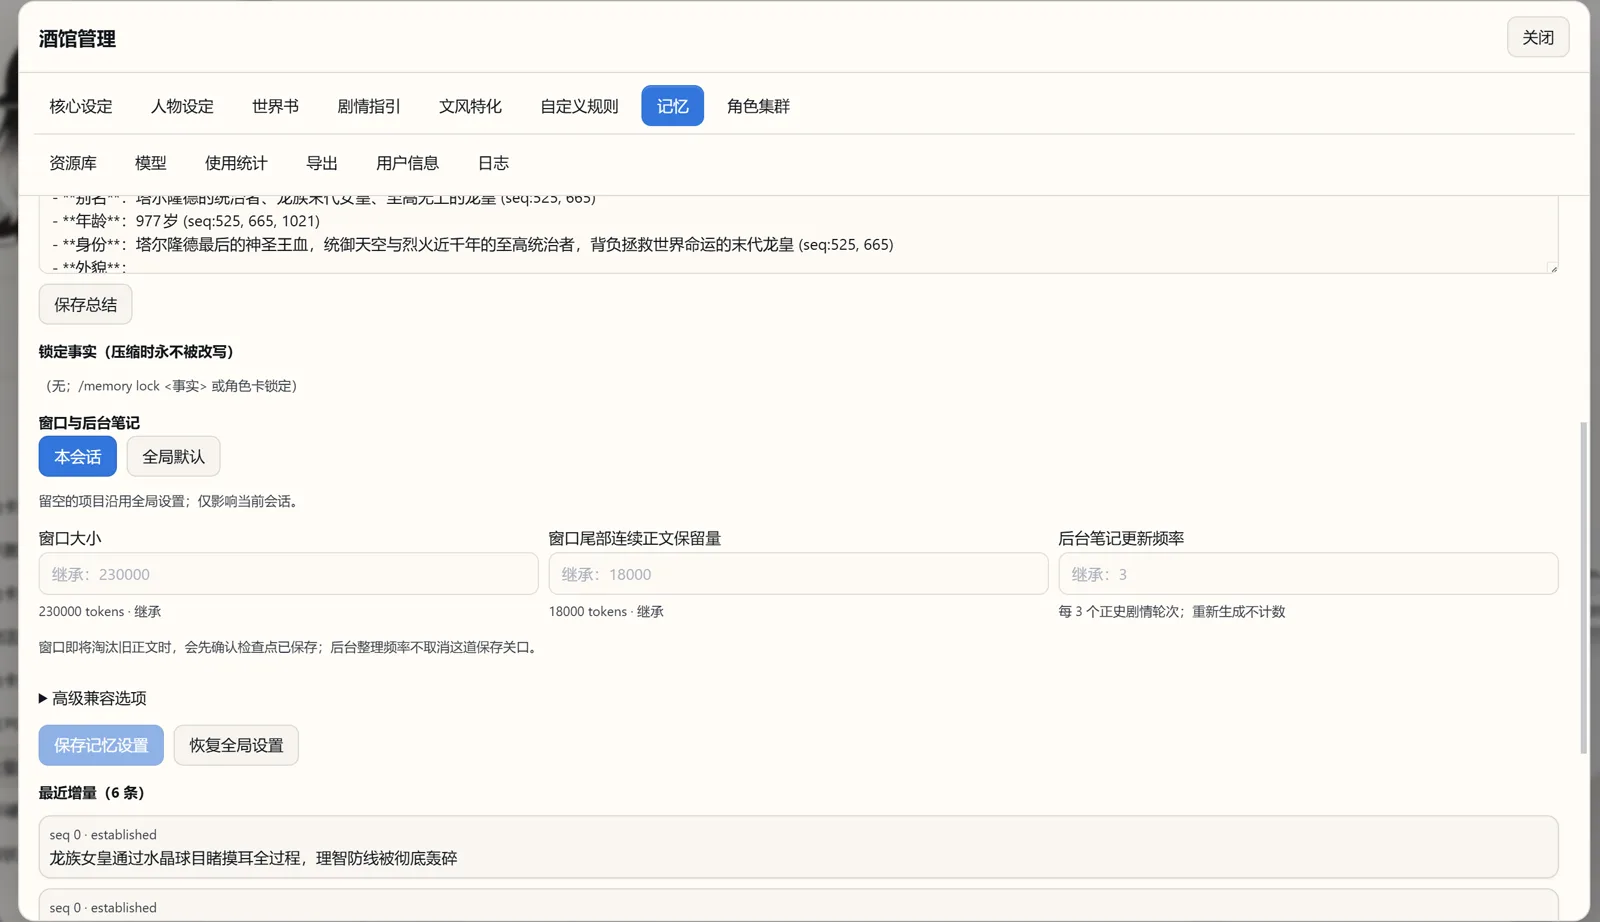
窗口大小、尾部保留量和后台笔记更新频率支持全局默认与会话覆盖,留空就沿用全局设置。截图里能看到的一组实际取值:
| 设置 | 含义 |
|---|---|
| 窗口大小 | 当前窗口的正文预算,按你实际使用的模型上下文容量来配。 |
| 窗口尾部连续正文保留量 | 切窗口时必须留住的近期正文,保证你正在读的那一段完整。 |
| 后台笔记更新频率 | 每多少个新增正史剧情轮次整理一次;重生成不计入。 |
| 记忆检索方式 | 关键词/语义/混合,以及应用到哪些会话。 |
切换检索方式不会删除已有索引。窗口即将淘汰旧正文时,会先确认检查点已保存;后台整理频率不会取消这道保存关口。
窗口装配、来源校验、笔记淘汰和原文回收都由程序完成,不产生模型请求。只有主代理真的决定去查历史时,才按你选的方式付出一次查询代价(语义与混合还需要嵌入模型,见嵌入模型)。
换一条世界线,就带着那条路线的经历继续向前;反复打磨同一幕,记忆会跟随你选中的版本。章节交接前,系统会先把需要延续的故事线索整理妥当。
嵌入模型
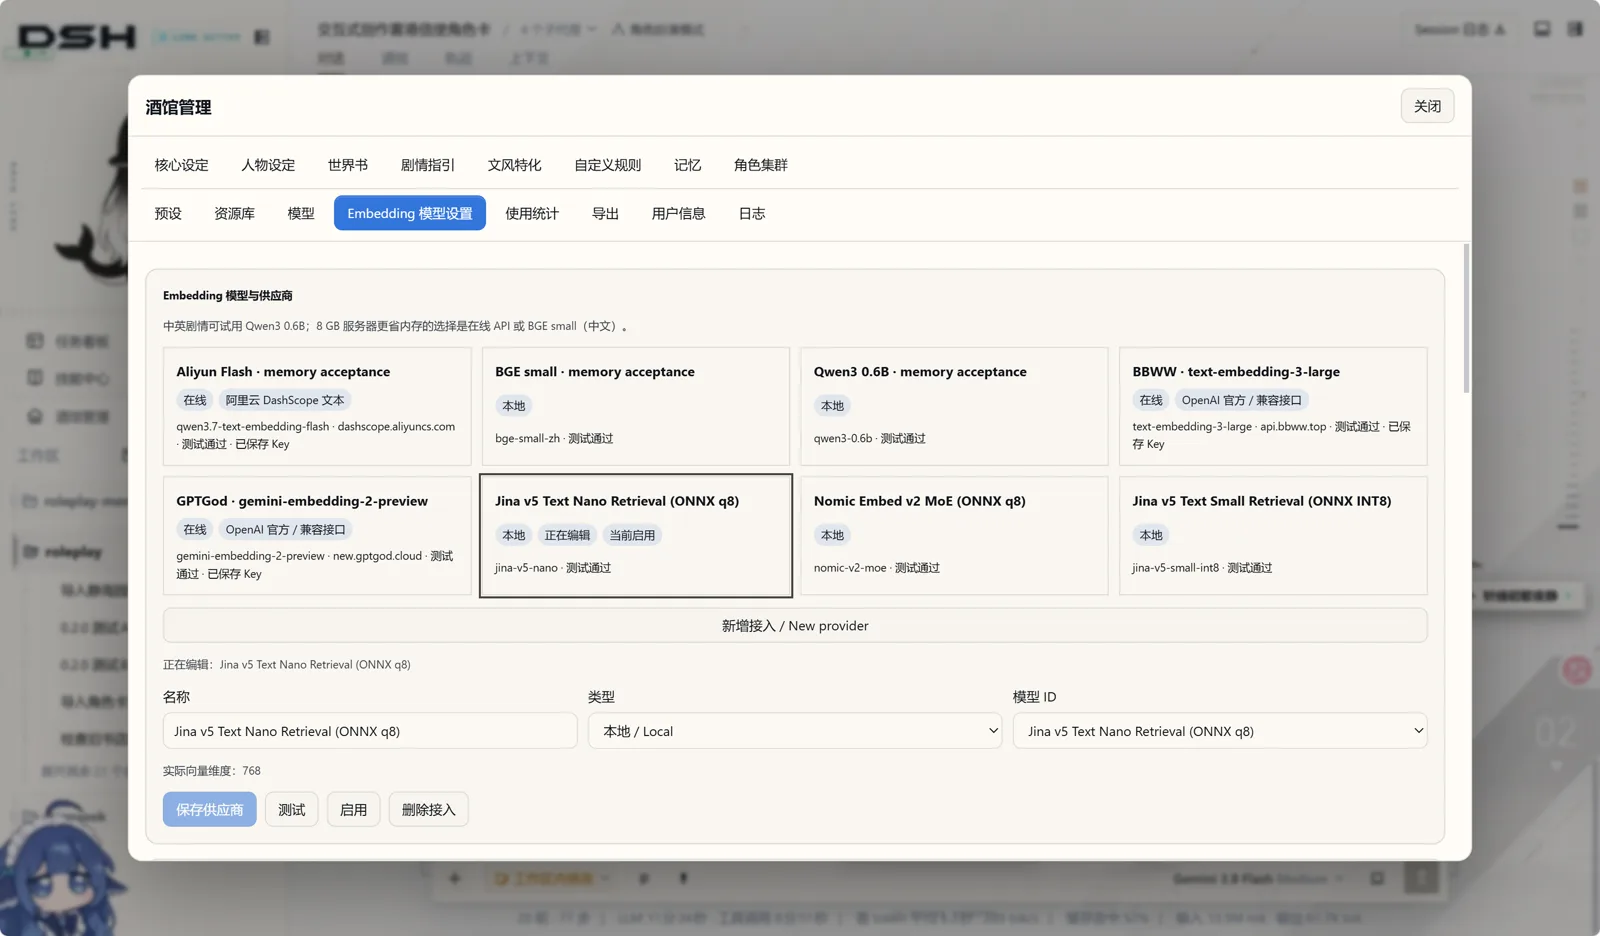
语义与混合检索需要向量,所以管理界面里多了一页独立的嵌入模型页(位于模型与使用统计之间)。
在线接入。 支持 DashScope、OpenAI 兼容接口和 OpenAI 官方:模型列表可刷新,也可以手动填写模型 ID,密钥只保存在服务端,并提供连接测试。
本地接入。 五种本地模型可以直接装:BGE small zh、Qwen3-Embedding 0.6B、Jina Nano、Jina Small INT8、Nomic q8,在独立编码进程中使用 ONNX Runtime 1.29.0 运行。下载显示真实字节进度、速度与预计剩余时间,支持暂停/取消/继续,并有 queued → downloading → verifying → preparing-runtime → self-testing → installed 的安装状态机。本地推理不需要 API Key,也不需要网络。
真实的索引/查询/测试/重试都会进入既有的用量统计。未知价格保持 N/A,失败不会虚构 token 数。
选哪个?BGE 快,跨语言能力弱一些;Qwen 在长正文上建索引更慢;分块到 5 万条时,检索时间已经接近上限。